
Hello les petits Biscuits !
Bienvenue sur la 50ème édition de Ruby Biscuit.
Vous êtes maintenant 603 abonnés 🥳
Bonne lecture.
Vous lisez Ruby Biscuit, la newsletter Rails de Capsens. S’abonner gratuitement
Où en est l’enquête ? Un mardi soir, un virement de 15 000 € s’est volatilisé sur une plateforme d’investissement : validé à 22h13, jamais arrivé chez le prestataire, figé en base en statut
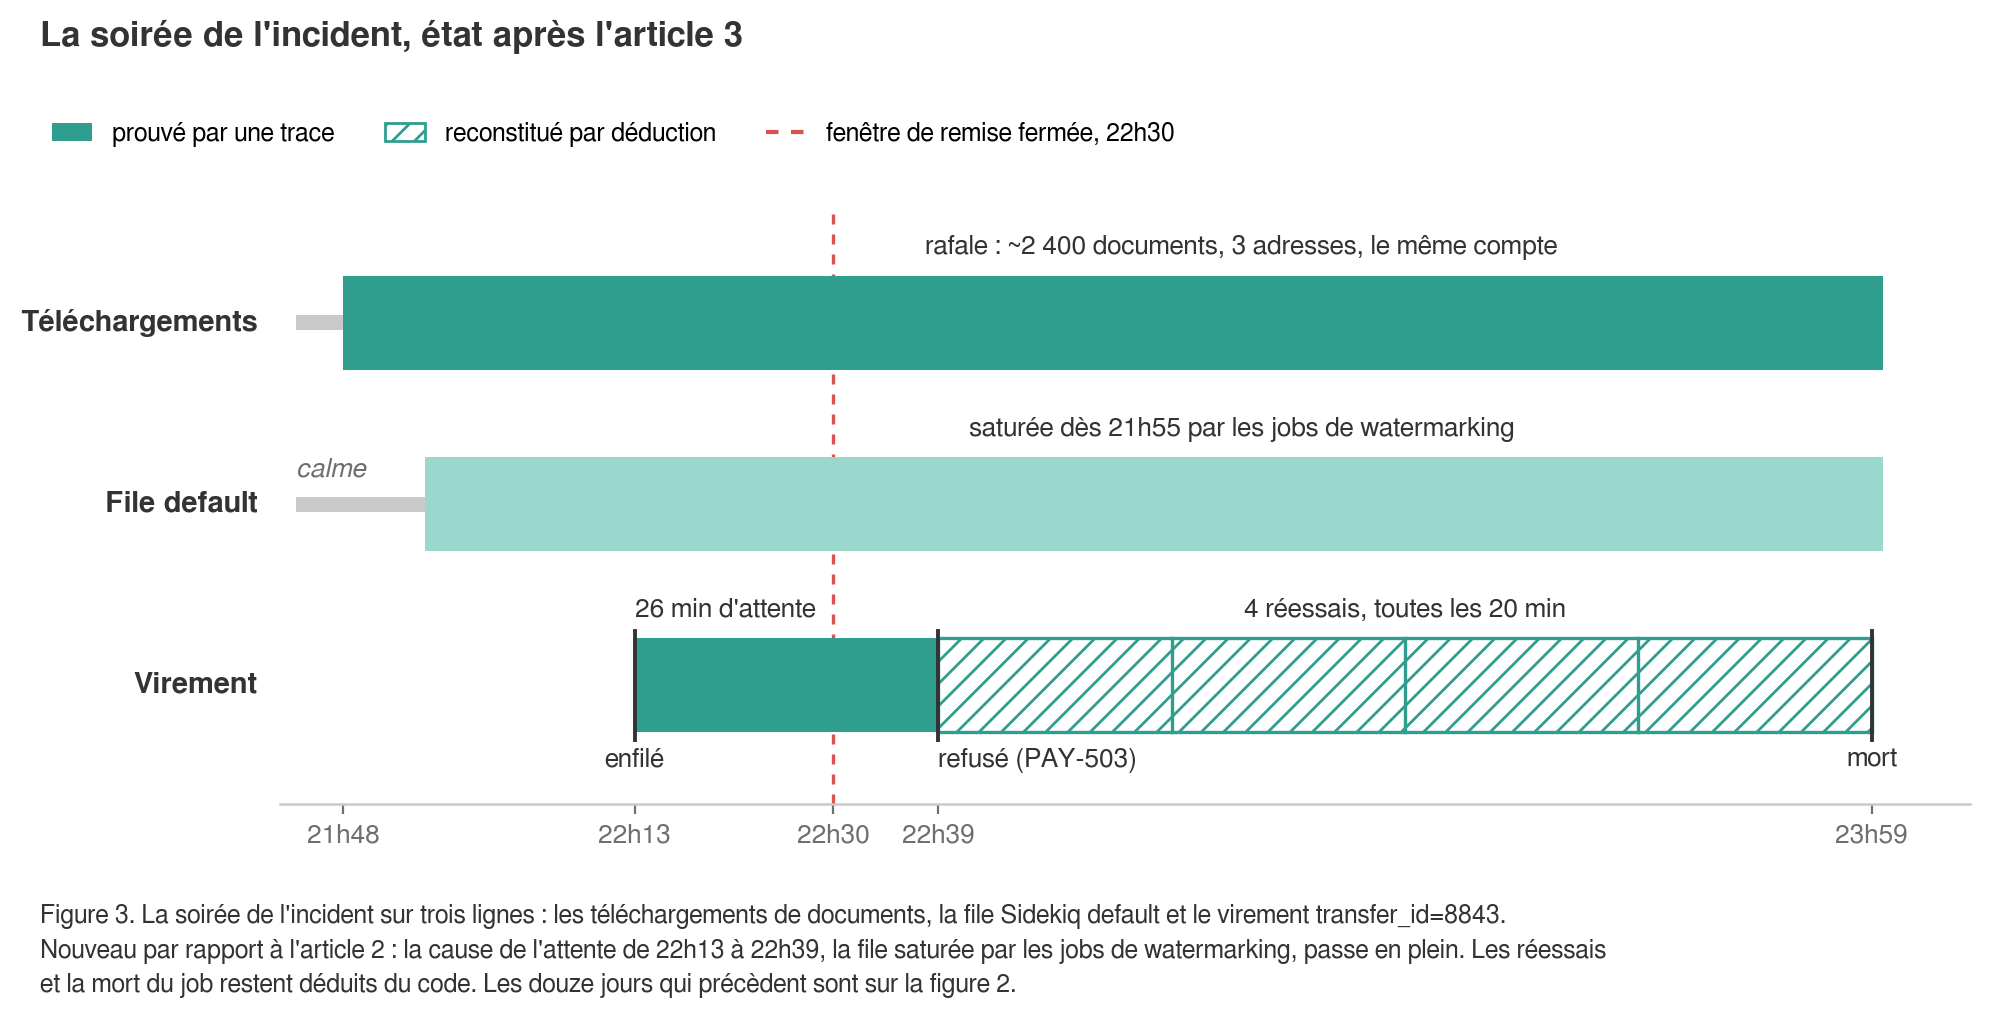
processing. L’article 2 a montré pourquoi aucune trace de sa mort n’existait et comment journaliser pour qu’elle existe la prochaine fois. Depuis, l’enquête a avancé d’un cran : le job s’est exécuté à 22h39, vingt-six minutes après son enfilement. Deux questions restent ouvertes. Pourquoi ce retard ? Et que faisaient cesGET /documentsen volume anormal à la même heure ?
Cette série suit un même incident, en fil rouge, au fil des techniques abordées. Les encadrés « ⏪ Ce que vous auriez vu » montrent les lignes de log ou les écrans que le bon outillage aurait produits cette nuit-là, et qui n’ont jamais existé faute de préparation. Vous pouvez les sauter : le reste se lit comme un tutoriel autonome.
Reconstituer à la main : ce que le fichier veut bien donner
Sans outillage, l’enquête se fait avec ce qui traîne : la base, les access logs de nginx, le log Rails brut, Redis.
La latence, d’abord. La table transfers porte un created_at (validation du virement) et un updated_at (dernier changement d’état, en pratique le passage en sent). Pour notre virement, le delta ne dit rien : resté en processing, il n’a jamais changé d’état. Pour les autres virements de la soirée, qui ont fini par partir, il apprend quelque chose : entre 22h et 23h, tous ont mis vingt à quarante minutes à passer en sent, contre quelques secondes la veille. Tous les jobs de la soirée étaient en retard dans la file d’attente, le nôtre comme les autres.
Le volume, ensuite. Les access logs de nginx contiennent chaque requête avec son chemin et son horodatage. Pour obtenir le nombre de téléchargements de documents par jour sur douze jours, il faut rassembler les fichiers de rotation, filtrer sur le chemin, extraire la date et compter :
awk '$7 ~ /^\/documents\// { split($4, t, ":"); d = substr(t[1], 2); c[d]++ }
     END { for (d in c) print d, c[d] }' access.log* | sort
La commande renvoie des dates et des nombres, qu’on colle dans un tableur pour obtenir une courbe. Comptez quelques heures pour récupérer les fichiers sur chaque serveur, et acceptez de perdre les lignes des conteneurs remplacés entre-temps. Et personne ne pourra reproduire ce graphique demain avec une question légèrement différente.
Note : le champ $7 suppose le format combined par défaut de nginx. Avec un format personnalisé, le numéro de colonne change et la commande casse en silence : zéro ligne, pas d’erreur.
Les réessais, enfin. Le job a échoué à sa première exécution. En relisant la politique de réessai de l’article 2 dans le code, on déduit les tentatives suivantes à 22h59, 23h19 et 23h39, et la mort du job à 23h59. Aucune ligne ne les atteste. Quant au dead set de Sidekiq, la réserve des jobs morts dont l’article 2 a décrit le plafond et l’éviction des plus anciens, il ne contient plus rien d’utile : abaissé à 1 000 jobs par la configuration héritée, il a été rempli dans la nuit par des milliers de jobs morts, et les paiements, morts parmi les premiers, ont été poussés dehors.
Note : le plafond par défaut est de 10 000 jobs (dead_max_jobs), conservés six mois (dead_timeout_in_seconds). Un job mort pèse de quelques centaines d’octets à quelques kilo-octets selon ses arguments ; mesurez ce que le dead set occupe réellement dans Redis avant de le réduire.
Quatre limites se dégagent. On ne peut ni compter ni agréger sans écrire un script par question. Les logs sont éparpillés entre serveurs et conteneurs éphémères. La rotation efface plus vite que la durée de conservation retenue à l’article 2. Et les journaux vivent sur la machine qu’ils sont censés surveiller.
Note (DORA) : ce dernier point a aussi une lecture réglementaire. L’article 12 du règlement délégué (UE) 2024/1774 impose aux entités financières des mesures protégeant les systèmes de journalisation et les logs contre la manipulation, la suppression et l’accès non autorisé, au repos comme en transit. L’exigence pèse sur le client régulé et redescend vers son prestataire par contrat. Des logs qui ne vivent que sur le serveur applicatif tombent avec lui, et un attaquant qui obtient la machine obtient aussi les traces de son passage, avec les moyens de les effacer.
Centraliser : sortir les logs de la machine
L’application écrit sur sa sortie standard, un tuyau achemine ce flux vers un service extérieur, et ce service indexe les lignes pour qu’on puisse les interroger.
Un drain est un tuyau qui recopie en continu la sortie de votre application vers un service extérieur. Un agent est un petit programme installé sur le serveur qui fait ce même travail en lisant les fichiers ou le flux des conteneurs. L’ensemble forme un pipeline de logs.
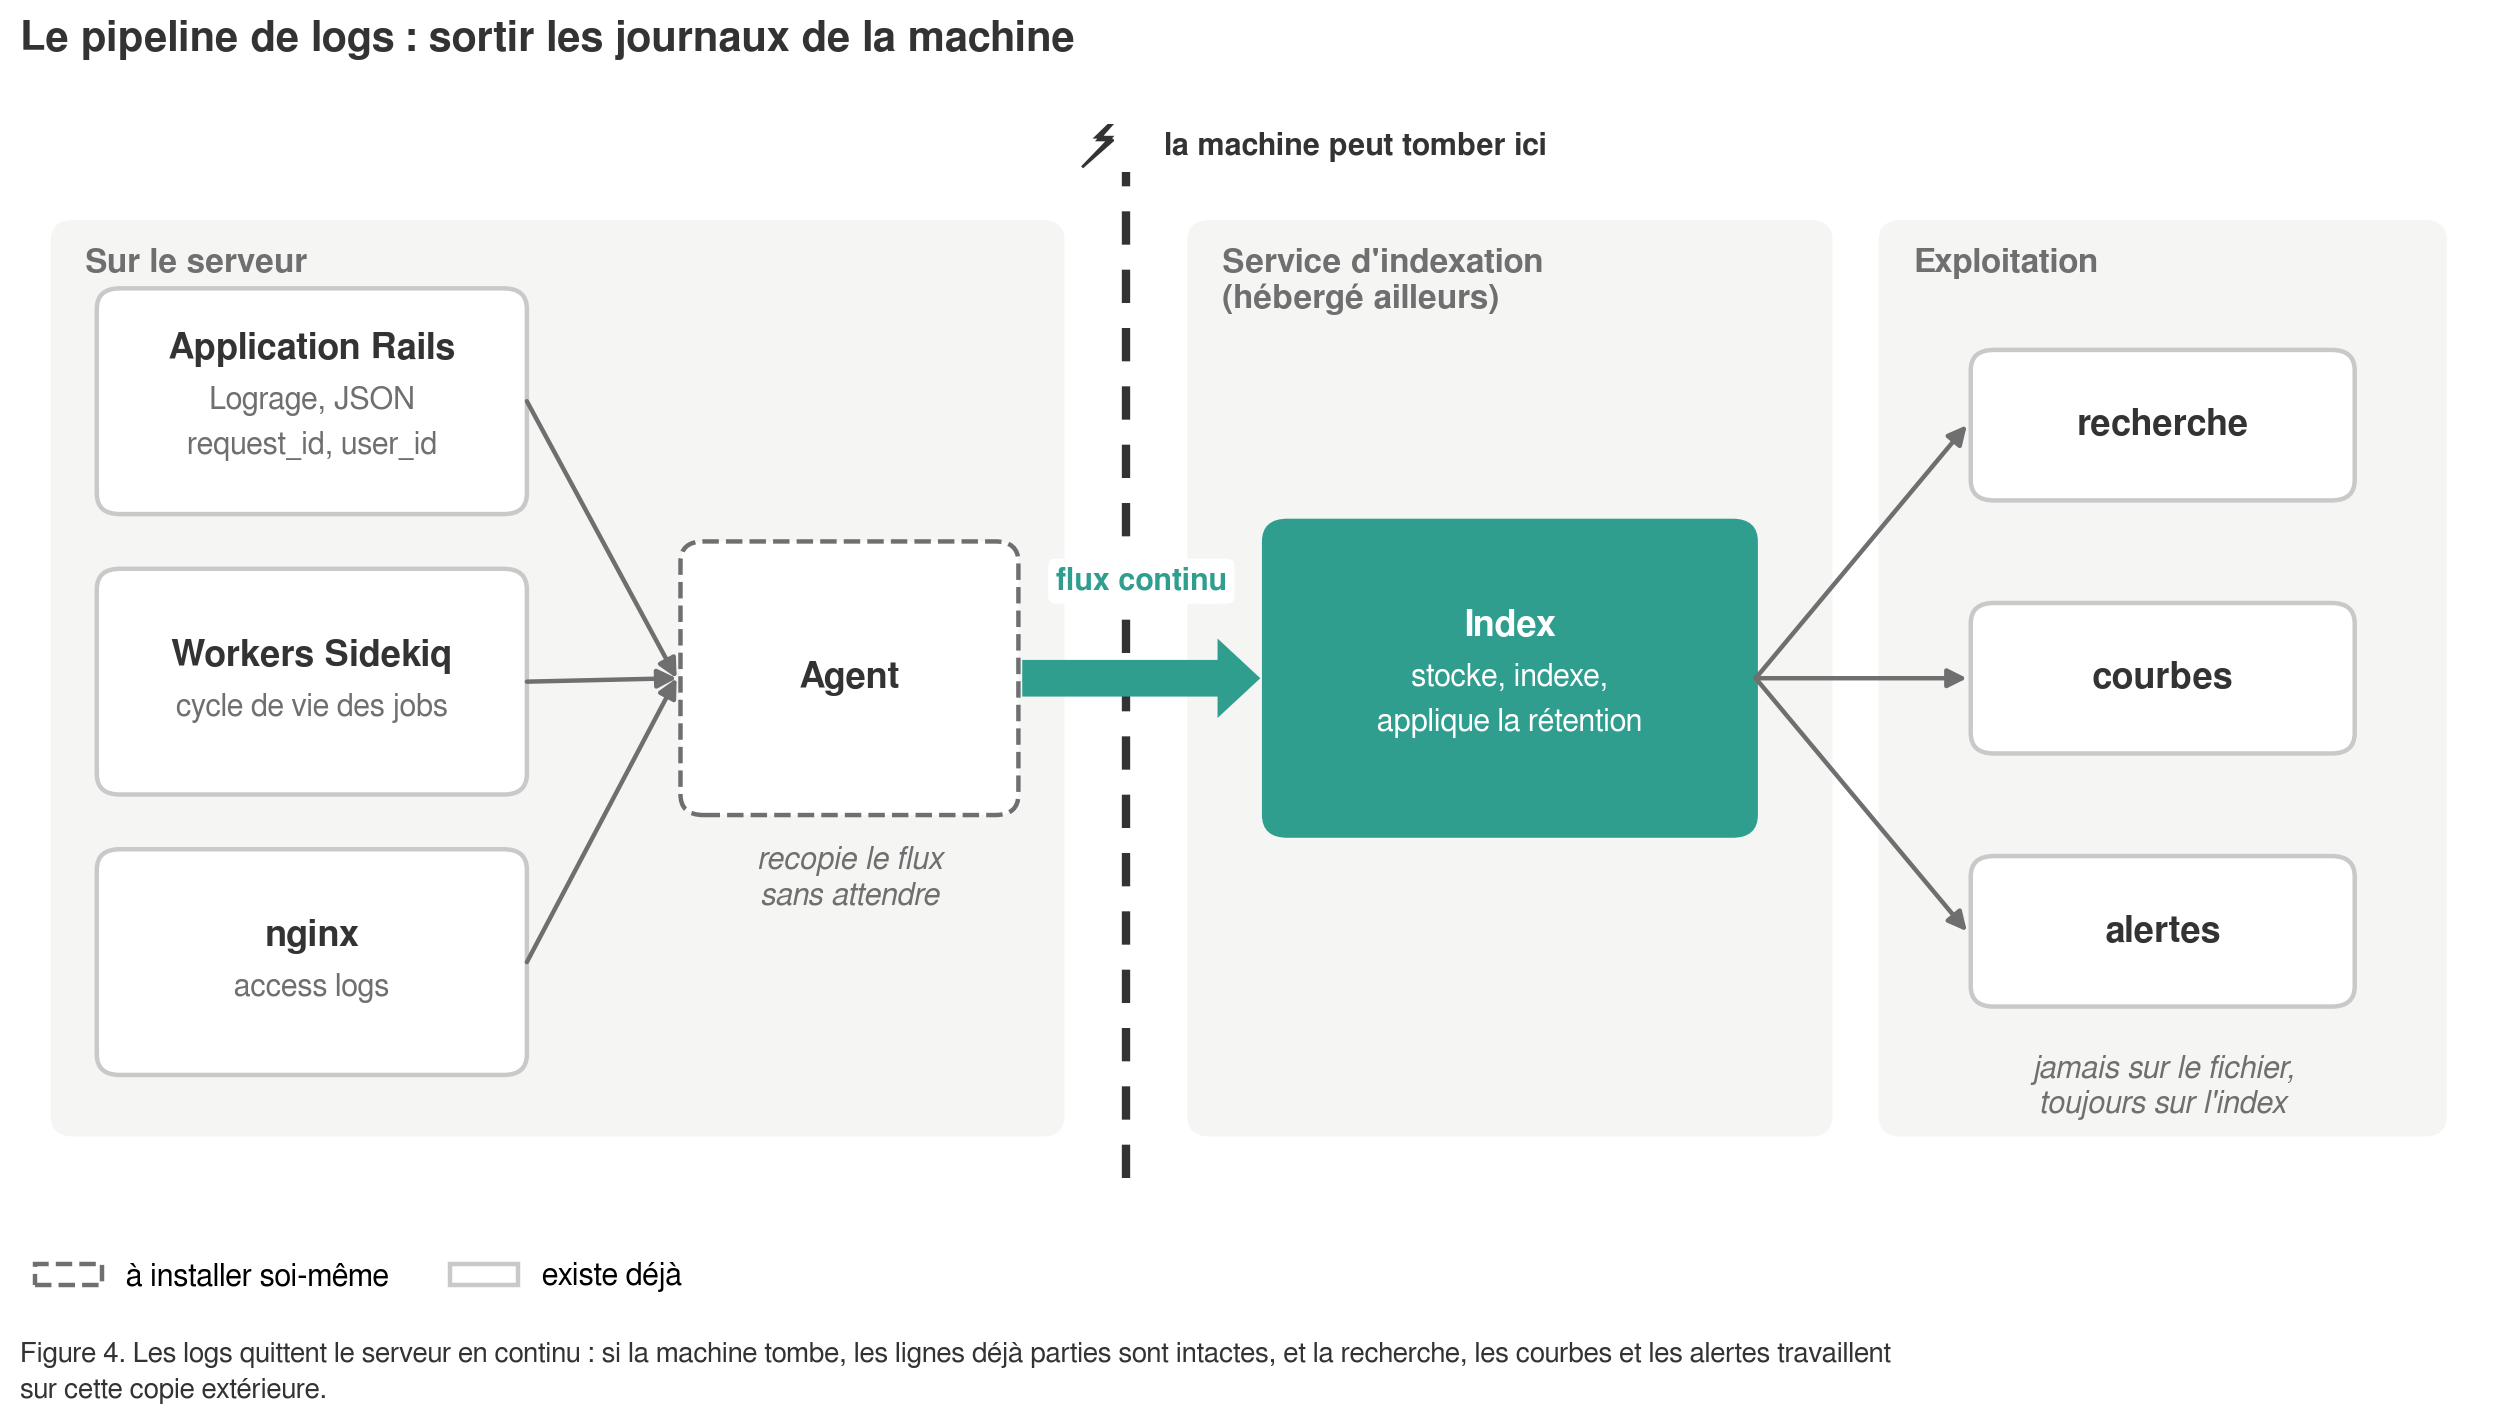
Côté Rails, il n’y a presque rien à faire si le travail de l’article 2 est fait : les logs sont en JSON avec Lograge et portent request_id et user_id.
Une application générée avec Rails 7.2 ou plus récent écrit déjà sur la sortie standard en production. Une application plus ancienne écrit dans log/production.log, sauf si la variable RAILS_LOG_TO_STDOUT est posée ; pour la basculer, on reprend ce que fait le template actuel :
# config/environments/production.rb (template Rails 7.2 / 8.0)
config.logger = ActiveSupport::Logger.new($stdout)
  .tap { |logger| logger.formatter = ::Logger::Formatter.new }
  .then { |logger| ActiveSupport::TaggedLogging.new(logger) }
La disponibilité, premier volet annoncé pour cet article, a en fait été traitée à l’article 1 avec le health check et la sonde externe ; je n’y reviens pas.
Lograge écrit dans Rails.logger, donc il suit ; Sidekiq écrit déjà sur la sortie standard. Le reste se règle côté hébergement, où les options se répartissent en trois familles. Les solutions intégrées à l’hébergeur (le drain de Heroku vers un add-on, CloudWatch Logs chez AWS, Cloud Logging chez Google) ne demandent aucune installation et sont rarement les plus confortables à interroger. Les suites d’observabilité (Datadog, New Relic, Grafana Cloud, Better Stack) réunissent recherche, courbes et alerting au même endroit, facturées au volume ingéré. Les piles auto-hébergées (Loki avec Grafana, OpenSearch, la pile Elastic) coûtent du temps d’exploitation plutôt que de l’argent par gigaoctet : bon arbitrage à partir d’un certain volume, mauvais en dessous.
Note (coût) : le volume est le premier poste de la facture et la première cause d’abandon d’un outil de centralisation. Deux leviers : ne pas logguer l’inutile, ce qui renvoie à l’article 2 ; et différencier les durées de conservation selon la finalité, car les logs de debug n’ont aucune raison de vivre aussi longtemps que les traces d’accès ou de paiement, que la LCB-FT peut porter à cinq ans (voir l’arbitrage de l’article 2) et pour lesquelles DORA demande de fixer et documenter une durée selon leur finalité, bien au-delà des six mois à un an que la CNIL recommande pour des logs ordinaires.
Note (confidentialité) : centraliser, c’est transmettre vos logs à un sous-traitant au sens du RGPD, avec le contrat et la ligne au registre des traitements qui vont avec. Le filtrage de l’article 2 prend ici tout son sens, et le piège signalé alors, les noms de fichiers dans les chemins d’URL que filter_parameters ne couvre pas, devient une fuite de données personnelles vers un tiers.
Interroger : compter, grouper, superposer
Une fois les logs indexés, ce qui demandait une matinée d’awk prend quelques secondes. Tous les outils savent les faire, avec des syntaxes différentes ; je décris donc les requêtes en français.
Compter. Filtrer sur path commençant par /documents/, grouper par jour, compter. Résultat : douze jours à quelques dizaines de téléchargements, puis plusieurs milliers le mardi. C’est la courbe de l’awk, obtenue cette fois par une requête que n’importe qui peut rejouer.
Grouper. Même filtre, grouper par user_id. C’est ici que le travail de l’article 2 paie : sans le custom_payload qui a ajouté user_id à chaque ligne, nginx n’offrait que des adresses IP. Trois adresses dans 203.0.113.0/24 ne mènent nulle part. Un user_id rattache chaque requête à un compte. Résultat, pour le mardi soir : un compte écrase tous les autres.
Superposer. Deux courbes sur la même échelle de temps : la profondeur de la file Sidekiq default (le nombre de jobs en attente, que Sidekiq::Queue.new("default").size expose et qu’un agent peut relever régulièrement) et la latence des paiements, délai entre enfilement et exécution d’après les lignes de cycle de vie de l’article 2. La profondeur complète la latence vue à l’article 1 : une file profonde de jobs rapides n’est pas un problème, un vieux job qui attend en est un, et les deux courbes ensemble disent lequel des deux on regarde.
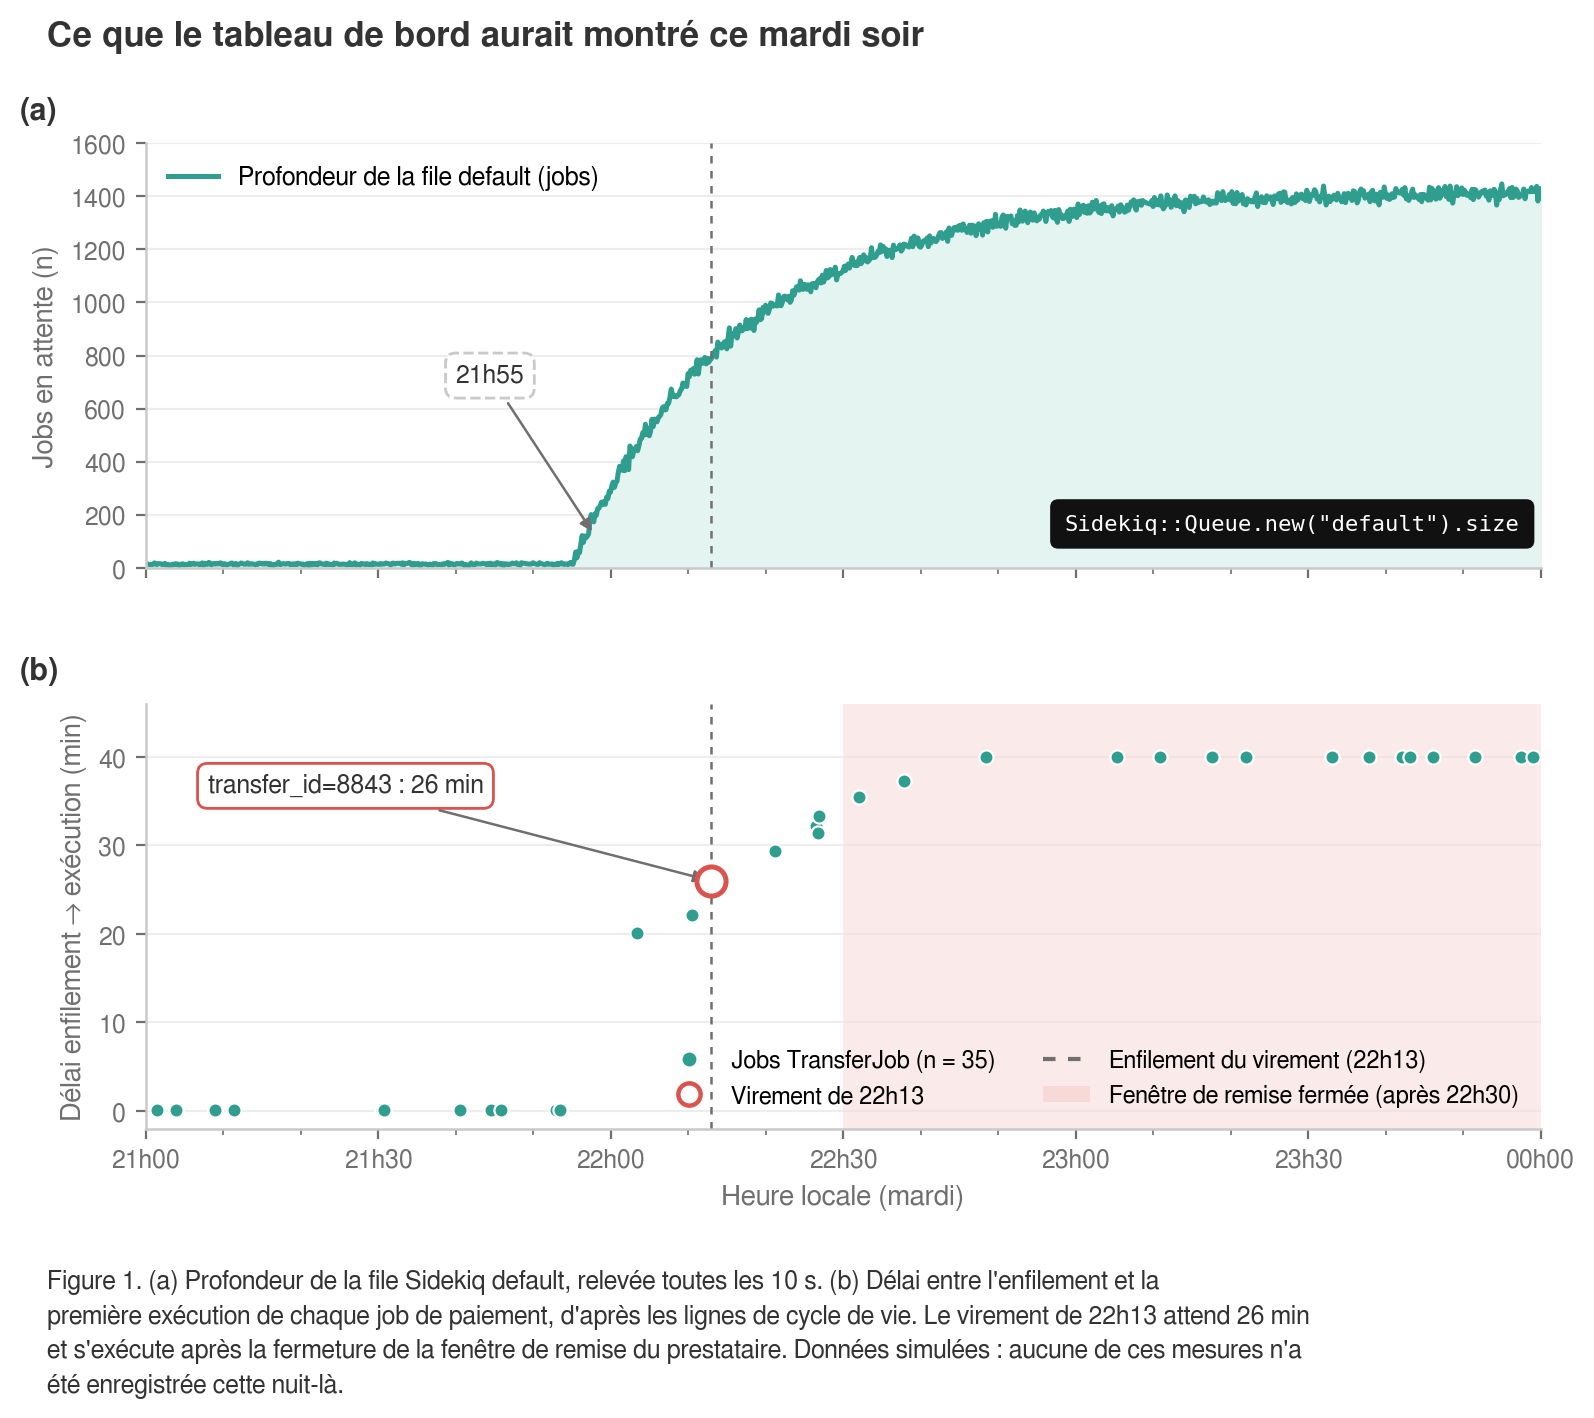
⏪ Ce que vous auriez vu. La figure 1. Rien de tout cela n’a été enregistré : la file n’était pas mesurée, et personne n’a regardé Redis avant le lendemain matin.
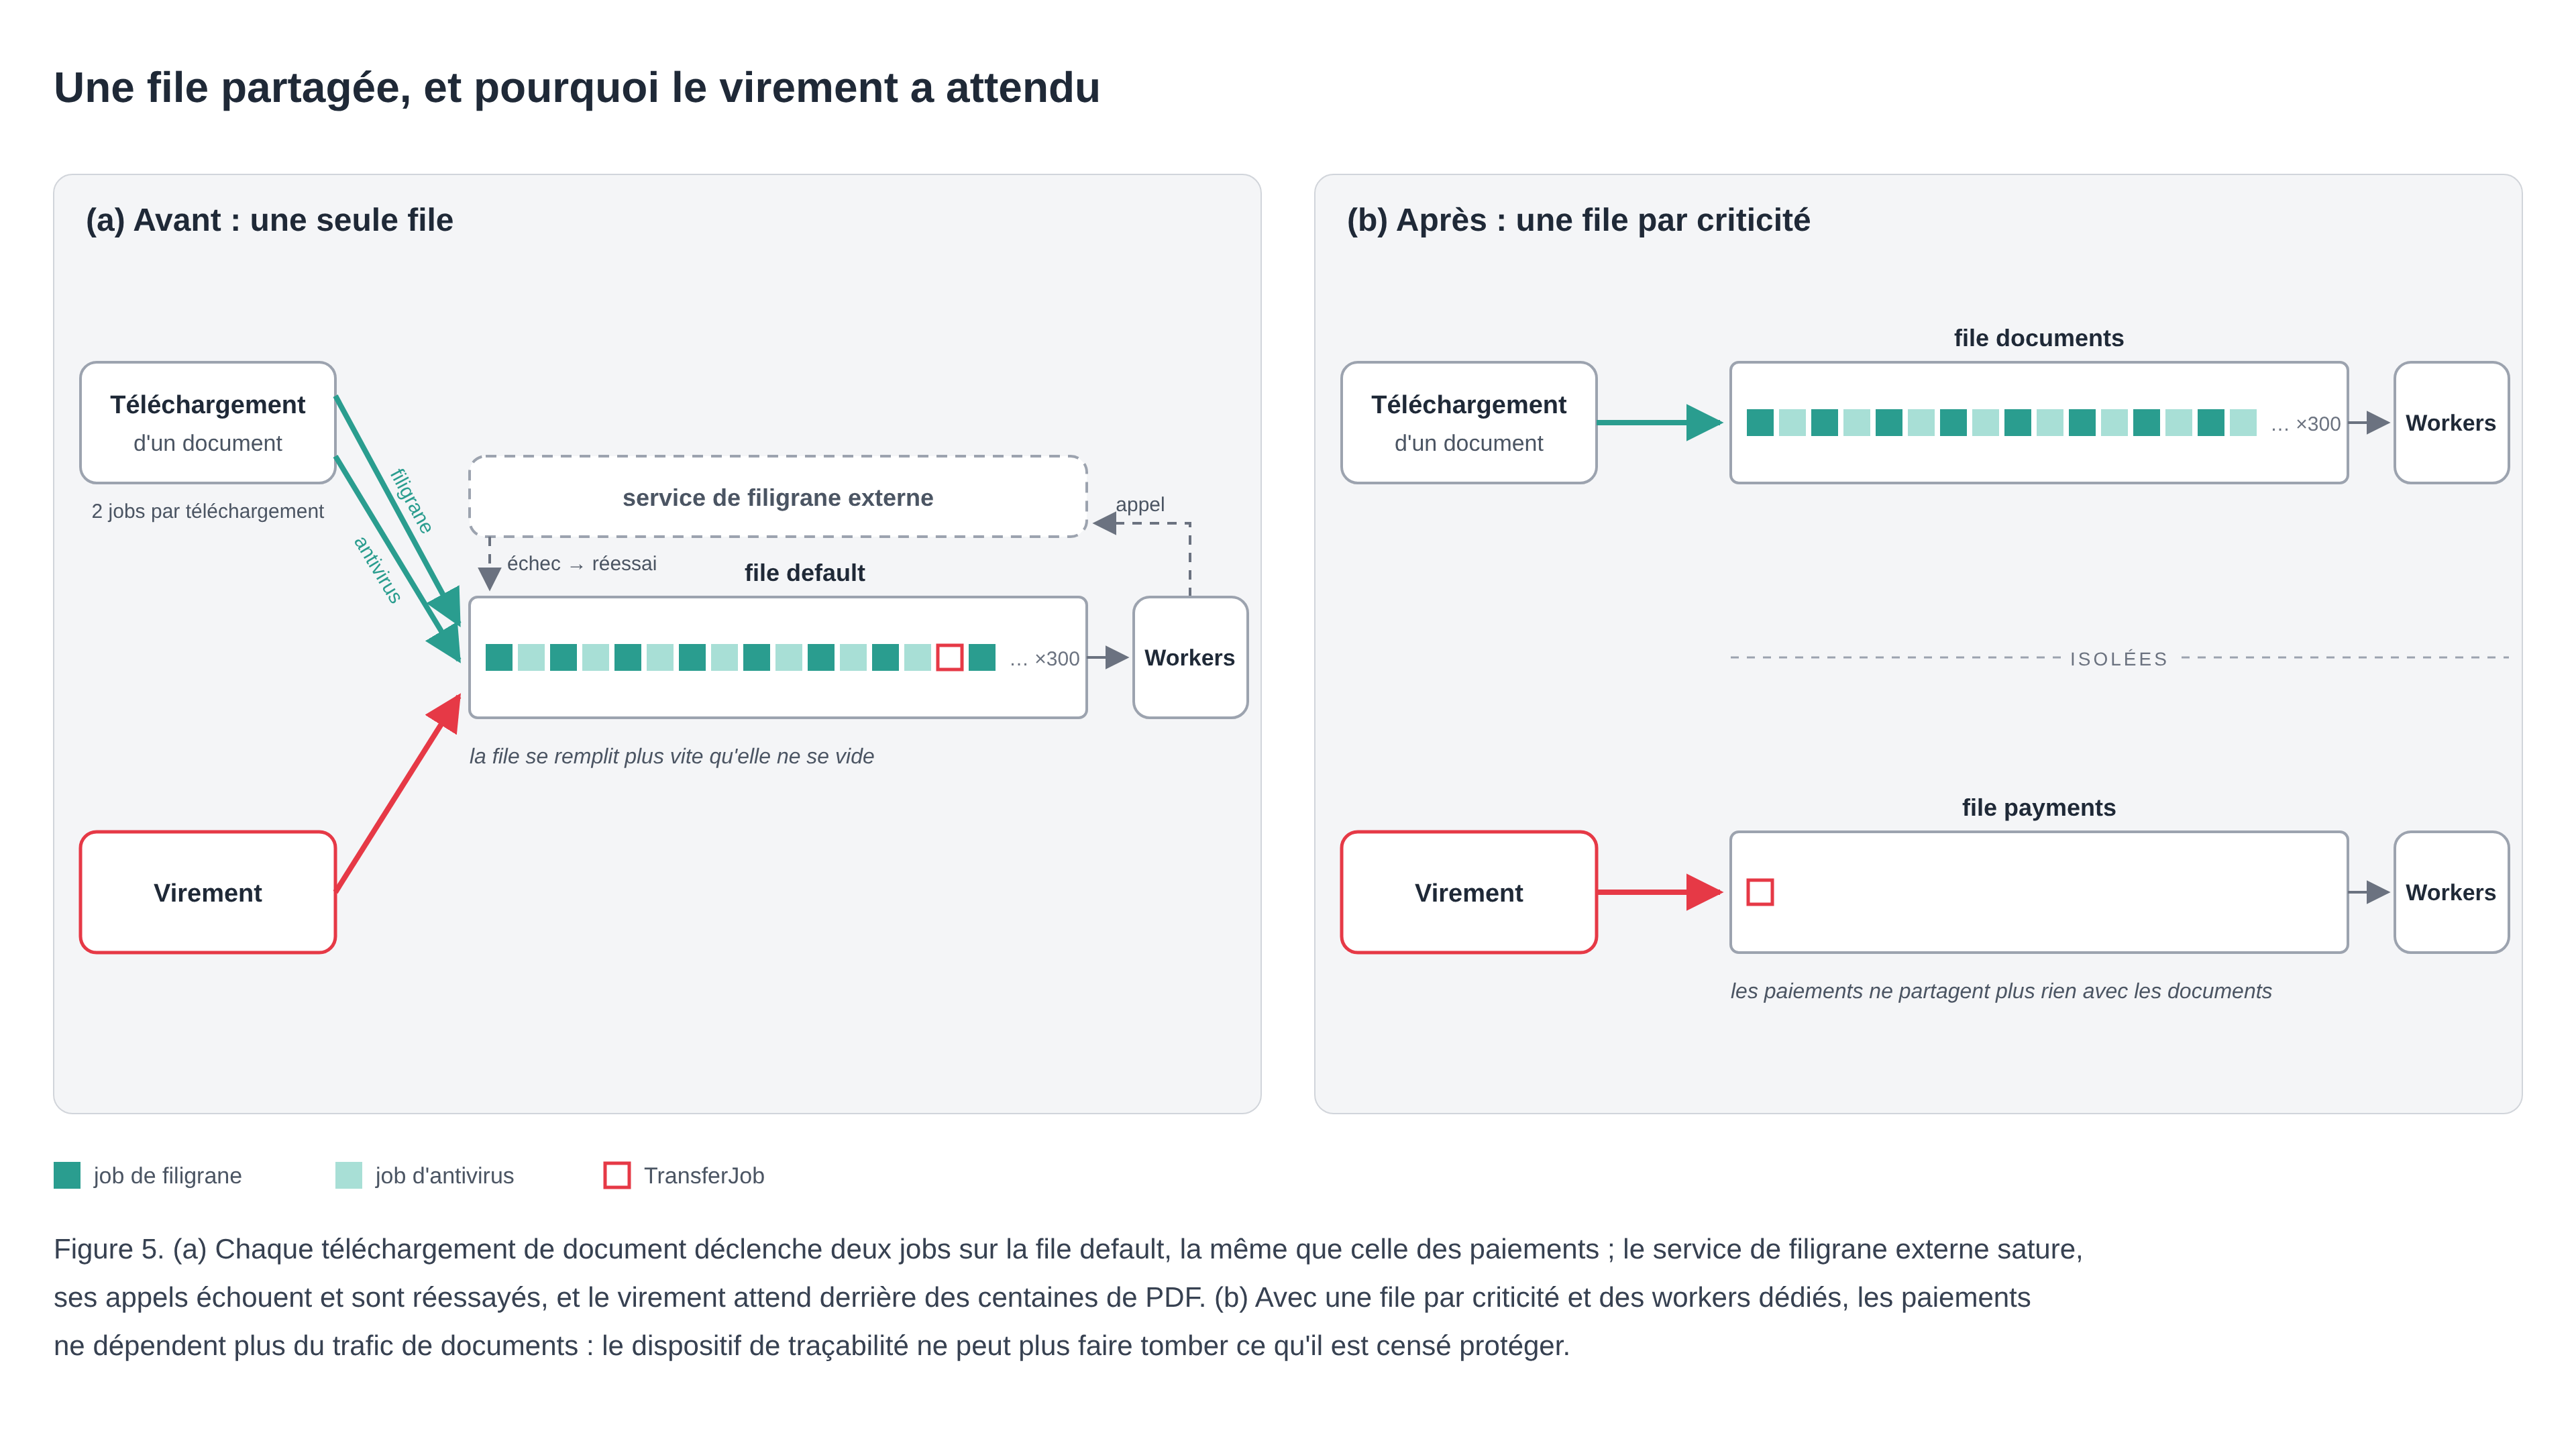
Une fois les deux courbes côte à côte, la mécanique apparaît. Chaque téléchargement déclenche deux jobs : un filigrane sur le PDF, qui appelle un service externe, et un scan antivirus. Ils tournent sur la file default. Les paiements aussi, puisque TransferJob déclare queue: :default. Le mardi soir, les téléchargements ont rempli la file plus vite que les workers (les processus qui exécutent les jobs) ne la vidaient, le service de filigrane a saturé, ses appels ont échoué puis ont été réessayés, et le virement a attendu derrière des centaines de PDF. La question de fiabilité posée à l’article 1 est réglée.
Le filigrane sert à savoir qui a téléchargé quoi si une pièce se retrouve dans la nature. C’est un dispositif de traçabilité, et c’est lui qui a provoqué la panne. Journaliser et tracer ont un coût, qui doit rester borné, et je retiens trois garde-fous : préférer une écriture synchrone et légère (une ligne de log, une insertion en base) à un job par événement ; ne jamais mettre un appel réseau externe sur le chemin d’une trace ; isoler les files critiques. Le principe de l’article 1, le monitoring ne doit jamais pouvoir faire tomber ce qu’il surveille, vaut aussi pour la traçabilité.
class TransferJob
  include Sidekiq::Job
  sidekiq_options queue: :payments, retry: 4
  # ...
end

class WatermarkDocumentJob
  include Sidekiq::Job
  sidekiq_options queue: :documents
  # ...
end
Note : déclarer la file ne suffit pas, il faut que des workers la consomment (option -q au lancement de Sidekiq, ou config/sidekiq.yml). Sans worker pour la consommer, une file accumule ses jobs indéfiniment, et rien ne le signale.
Superposer deux courbes suppose que l’horloge du serveur web, celle des workers et celle de la base racontent la même minute. Avec deux minutes d’écart, la cause semble arriver après l’effet.
Note (DORA) : le même article 12 exige la synchronisation des horloges de tous les systèmes sur une source de temps de référence documentée. Deux corollaires : logguer en UTC partout, et se méfier des horodatages posés par l’outil de collecte à la réception plutôt que par l’application à l’émission. Un agent qui a pris du retard date toutes ses lignes en bloc, à la seconde où il l’a rattrapé.
Note : les logs ne répondent pas à tout. L’article 2 a retiré les temps de rendu par partial en condensant chaque requête sur une ligne ; pour traquer une vue lente ou une requête SQL qui dérive, c’est l’APM (Application Performance Monitoring) qui prend le relais, en traçant chaque requête étape par étape. La plupart des suites citées plus haut en proposent un, et c’est souvent le même agent qui collecte logs, métriques et traces.
Les erreurs méritent leur propre outil
Centraliser des logs et suivre des erreurs ne répondent pas à la même question. Le premier dit ce qui s’est passé entre 22h et 23h. Le second regroupe les occurrences d’une même exception, garde la trace d’appel et le contexte, et dit si elle est nouvelle ou en augmentation, et depuis quel déploiement. Les options se ressemblent (Sentry, Honeybadger, Rollbar, Bugsnag, AppSignal) ; les écarts se jouent sur le prix par événement, l’intégration Rails et Sidekiq, et la qualité du regroupement.
À la configuration, trois réglages comptent : associer chaque erreur à une version déployée (le SHA de commit) ; y attacher le request_id de l’article 2, pour sauter de l’erreur aux logs de la même requête ; et n’y envoyer pas plus de données personnelles que dans les logs, car ces outils capturent les paramètres de requête par défaut et ne reprennent pas tous le filter_parameters de Rails ; vérifiez-le outil par outil.
Note : dans notre nuit, le service de filigrane saturé a levé des centaines de Net::ReadTimeout. Un outil de suivi d’erreurs les aurait regroupées en une seule entrée, avec un compteur qui grimpe dès le début de la soirée. Cette entrée est une alerte toute trouvée, sans avoir à lire une ligne de log.
Alerter sans être noyé
Une alerte sert à faire agir quelqu’un. Si la personne qui la reçoit n’a rien à faire, supprimez-la.
On rate son alerting de deux manières : aucune alerte, c’est notre nuit ; ou trop d’alertes, et au bout de quelques semaines on les acquitte sans les lire.
Ce qui se règle : le seuil ; la durée de dépassement avant déclenchement, pour absorber les à-coups ; et qui reçoit quoi. Le choix du canal selon la criticité a été posé à l’article 1.
Notre incident en réclamait trois, qui n’existaient pas. La profondeur de la file default au-dessus de son niveau habituel pendant plus de cinq minutes : à 22h, quelqu’un aurait su qu’une file débordait, avant le premier paiement en retard. La mort d’un job de paiement, déclenchée par la ligne [payments] transfer job dead que le sidekiq_retries_exhausted de l’article 2 écrit au niveau error : à minuit, quelqu’un l’aurait su avant le client. Et l’absence de logs : si l’application cesse d’émettre pendant dix minutes, ou si l’agent cesse de transmettre, quelqu’un doit le savoir. Qui surveille le logueur ?
Note (DORA) : cette troisième alerte répond à une exigence explicite de l’article 12, qui demande des mesures pour détecter une défaillance du système de journalisation. On l’oublie souvent : les outils sont faits pour voir des pics, pas des silences.
Note (OPSEC) : les seuils donnés ici sont des ordres de grandeur. Les vôtres dépendent de votre trafic et n’ont rien à faire dans un article public ni dans un dépôt trop largement accessible : ils indiquent aussi ce que vous ne surveillez pas.
Ce que l’outillage ne fait pas
Tout ce qui précède répond à deux questions : combien, et quand. Aucun de ces outils ne répond à pourquoi, ni à est-ce normal.
Un compte qui télécharge beaucoup de documents peut être un client zélé qui prépare sa déclaration fiscale, un cabinet d’audit mandaté par l’émetteur, ou autre chose, et la courbe est la même dans les trois cas. Distinguer ces cas demande de comparer un comportement à sa propre normale, et c’est le sujet de l’article 4.
Un seul compte
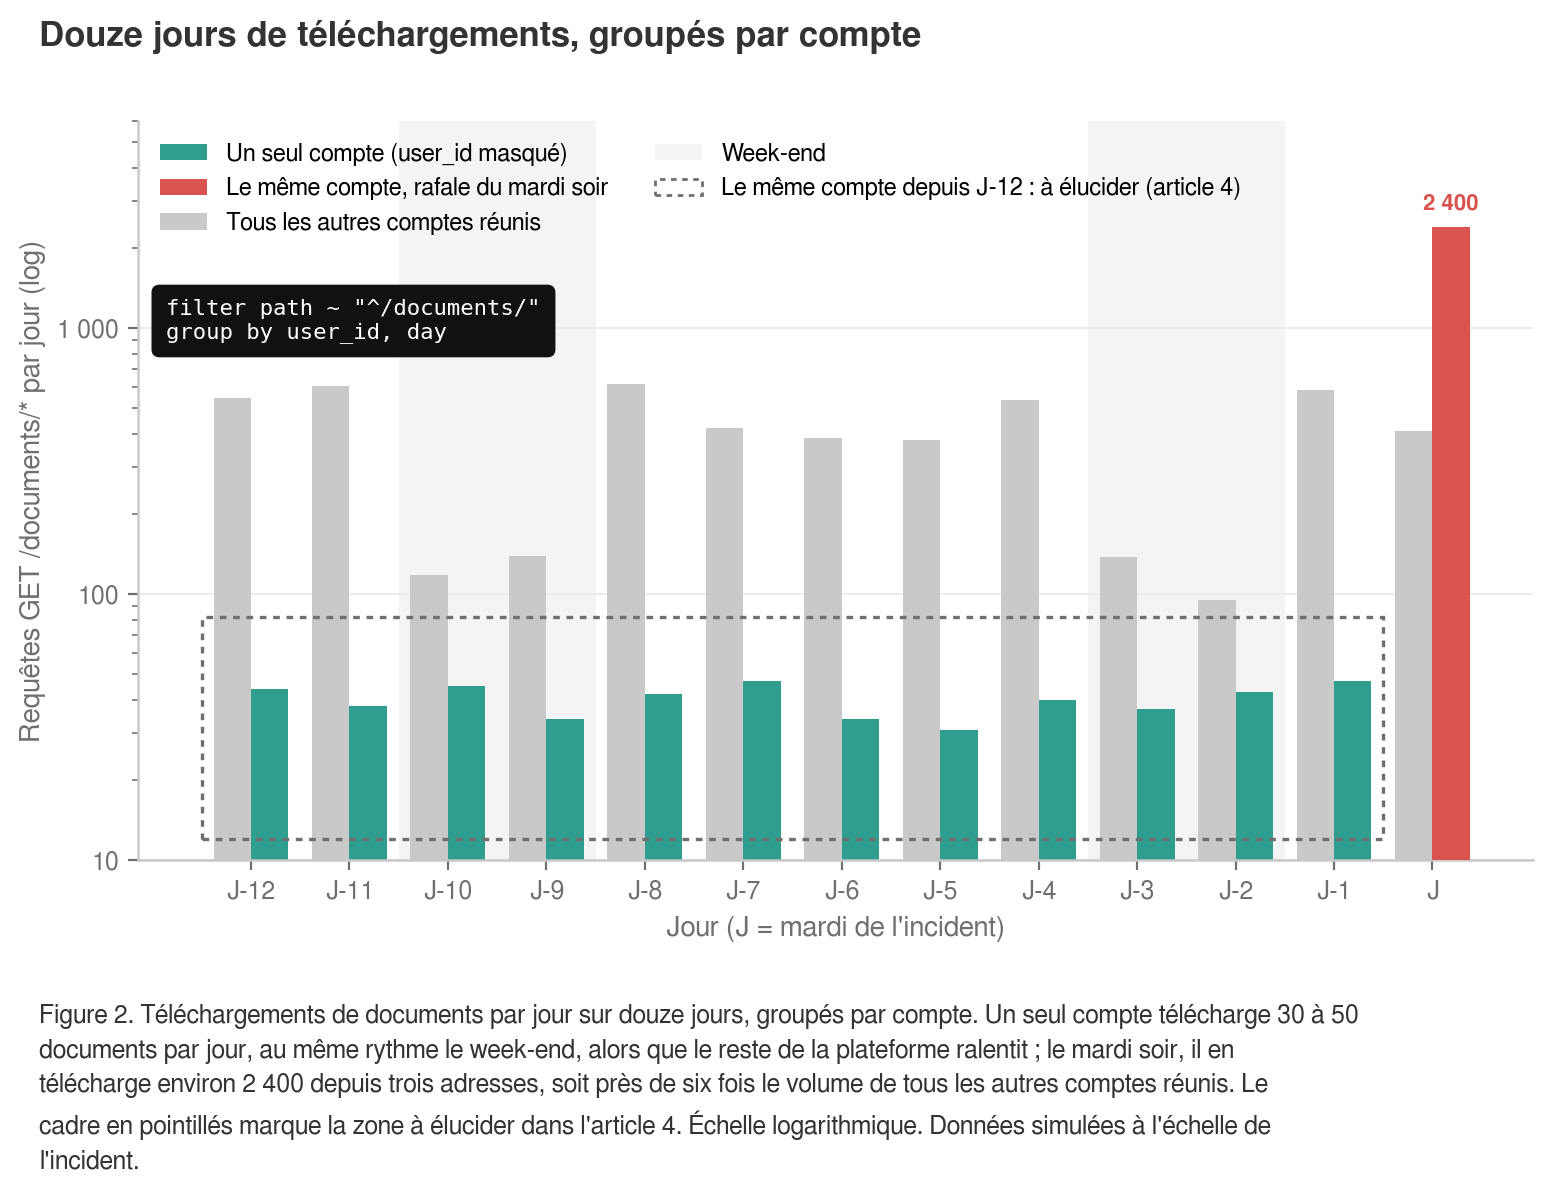
Revenons à la requête groupée par user_id, étendue aux douze jours (figure 2).
Elle montre une régularité qui ne ressemble à aucun usage que je connaisse. Pendant douze jours, quelques dizaines de téléchargements par jour, à peu près au même rythme, sans week-end. Puis, le mardi à 21h48, une rafale : des milliers de documents dans la soirée, depuis trois adresses. Et du premier jour à la dernière minute, c’est le même compte qui télécharge.
La question qui ouvre l’article suivant : ce compte est-il utilisé par son propriétaire ?
En deux mots
On est passé de la ligne au chiffre, puis du chiffre à la courbe. Chaque étape a demandé un outil, et chaque outil a demandé que les logs soient exploitables, donc le travail de l’article précédent. Si vous partez de zéro, commencez par la centralisation : la recherche, les courbes et les alertes s’appuient toutes dessus.
On sait maintenant combien. Reste à savoir si c’est normal : prochain épisode, comparer un comportement à sa propre normale.
— Inès, Responsable de la Sécurité des Systèmes d’Information chez Capsens
Pour aller plus loin
Journalisation sous DORA : article 12 du règlement délégué (UE) 2024/1774, EUR-Lex
Logs sur la sortie standard par défaut : template
production.rbde Rails 7.2 et version couranteProfondeur et latence des files : API Sidekiq, wiki officiel
Dead set,
dead_max_jobsetdead_timeout_in_seconds: Error Handling, wiki SidekiqDéclarer et consommer des files : Advanced Options, wiki Sidekiq
Logs structurés en une ligne par requête : Lograge, dépôt et README
Format
combineddes access logs : modulengx_http_log_module, documentation nginxSous-traitant et registre des traitements : articles 28 et 30 du RGPD, EUR-Lex
Durée de conservation des journaux : recommandation de la CNIL sur la journalisation